스마트시티 융합기술세미나 · 과제3: 도시 현상을 지표로 측정하고 공간적으로 해석하기

학원가는 도시의 다양성이 낮을까?

요약

결론. 학원가의 업종 다양성은 학원을 포함하면 다소 낮지만, 학원을 제외하면 서울의 다른 동과 차이가 거의 없다. 낮은 다양성은 학원이라는 큰 업종에서 비롯된 것으로 해석된다.

분석 개요

질문답핵심 수치
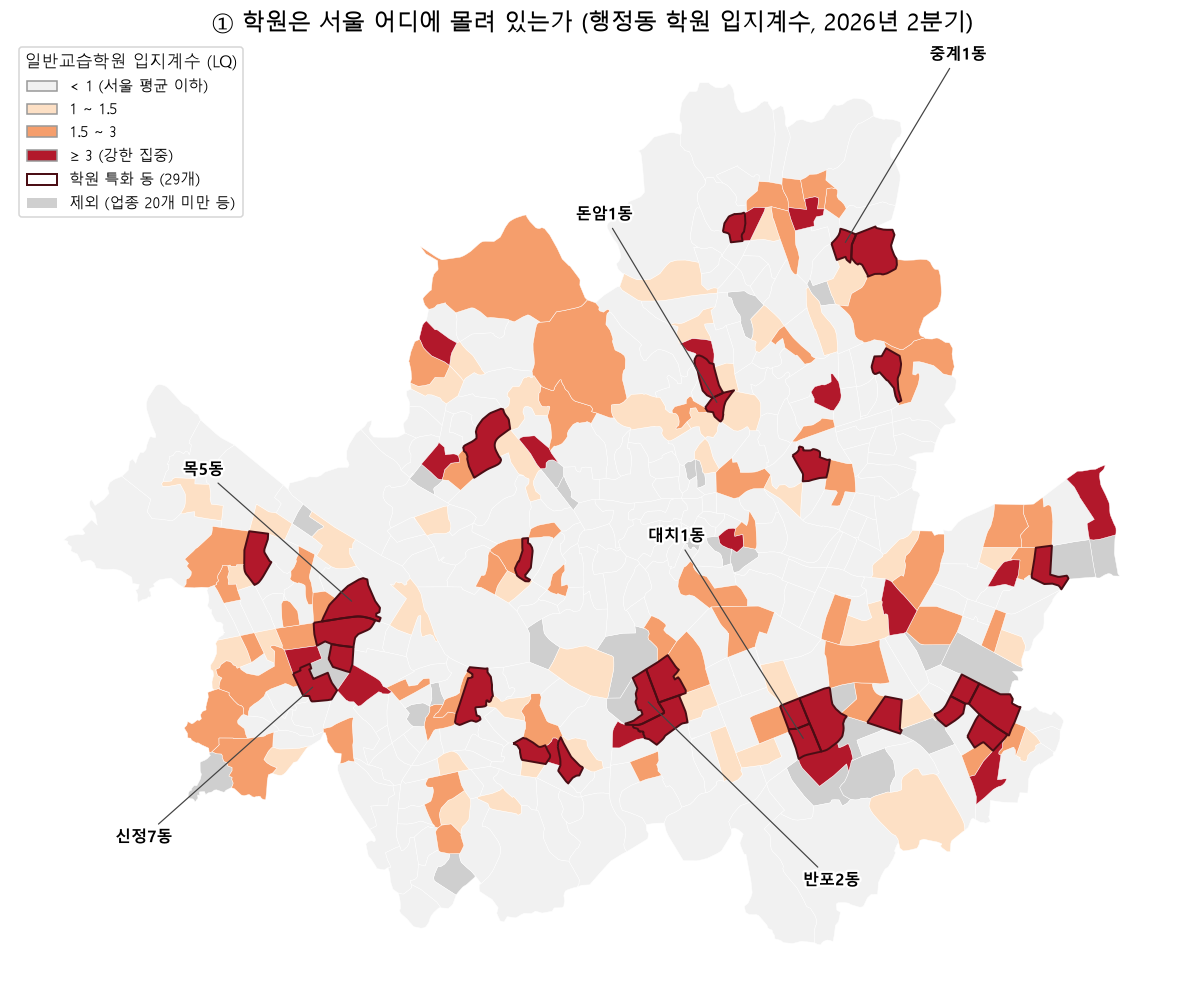
① 학원은 어디에 몰려 있는가소수의 동에 몰려 있고, 여러 거점으로 나뉜다학원 특화 동(LQ 1.5 이상, 학원 비중이 서울 평균보다 10%p 이상 높은 동) 29곳. LQ 상위는 목5동 16.2, 중계1동 13.4, 대치1동 11.6
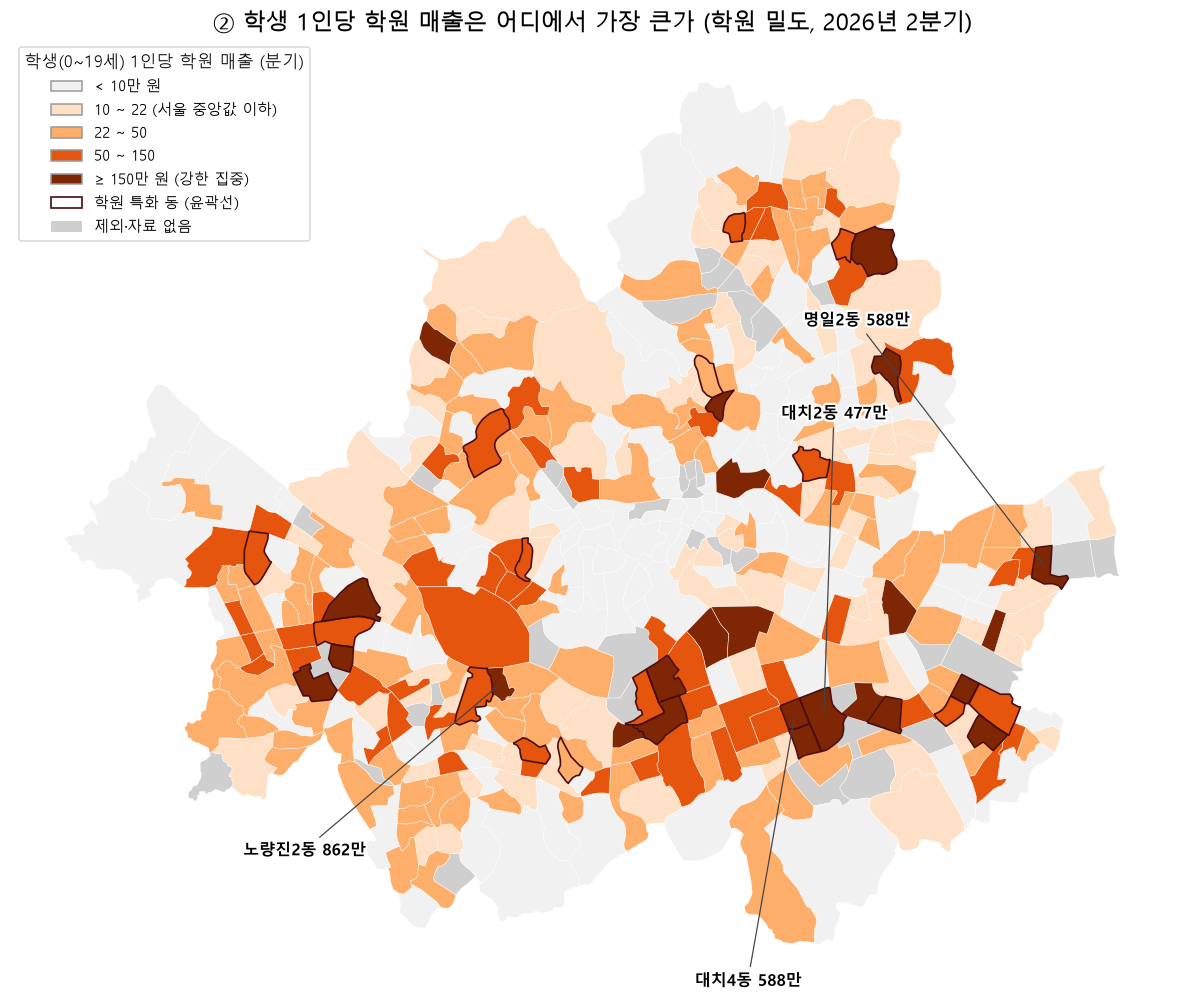
② 학생 수에 비해 학원 매출이 가장 큰 곳은 어디인가대치4동, 명일2동, 대치2동 (노량진2동은 예외)학생 1인당 학원 매출은 대치4동 588만 원(분기)으로 서울 동 중앙값 22만 원의 약 27배
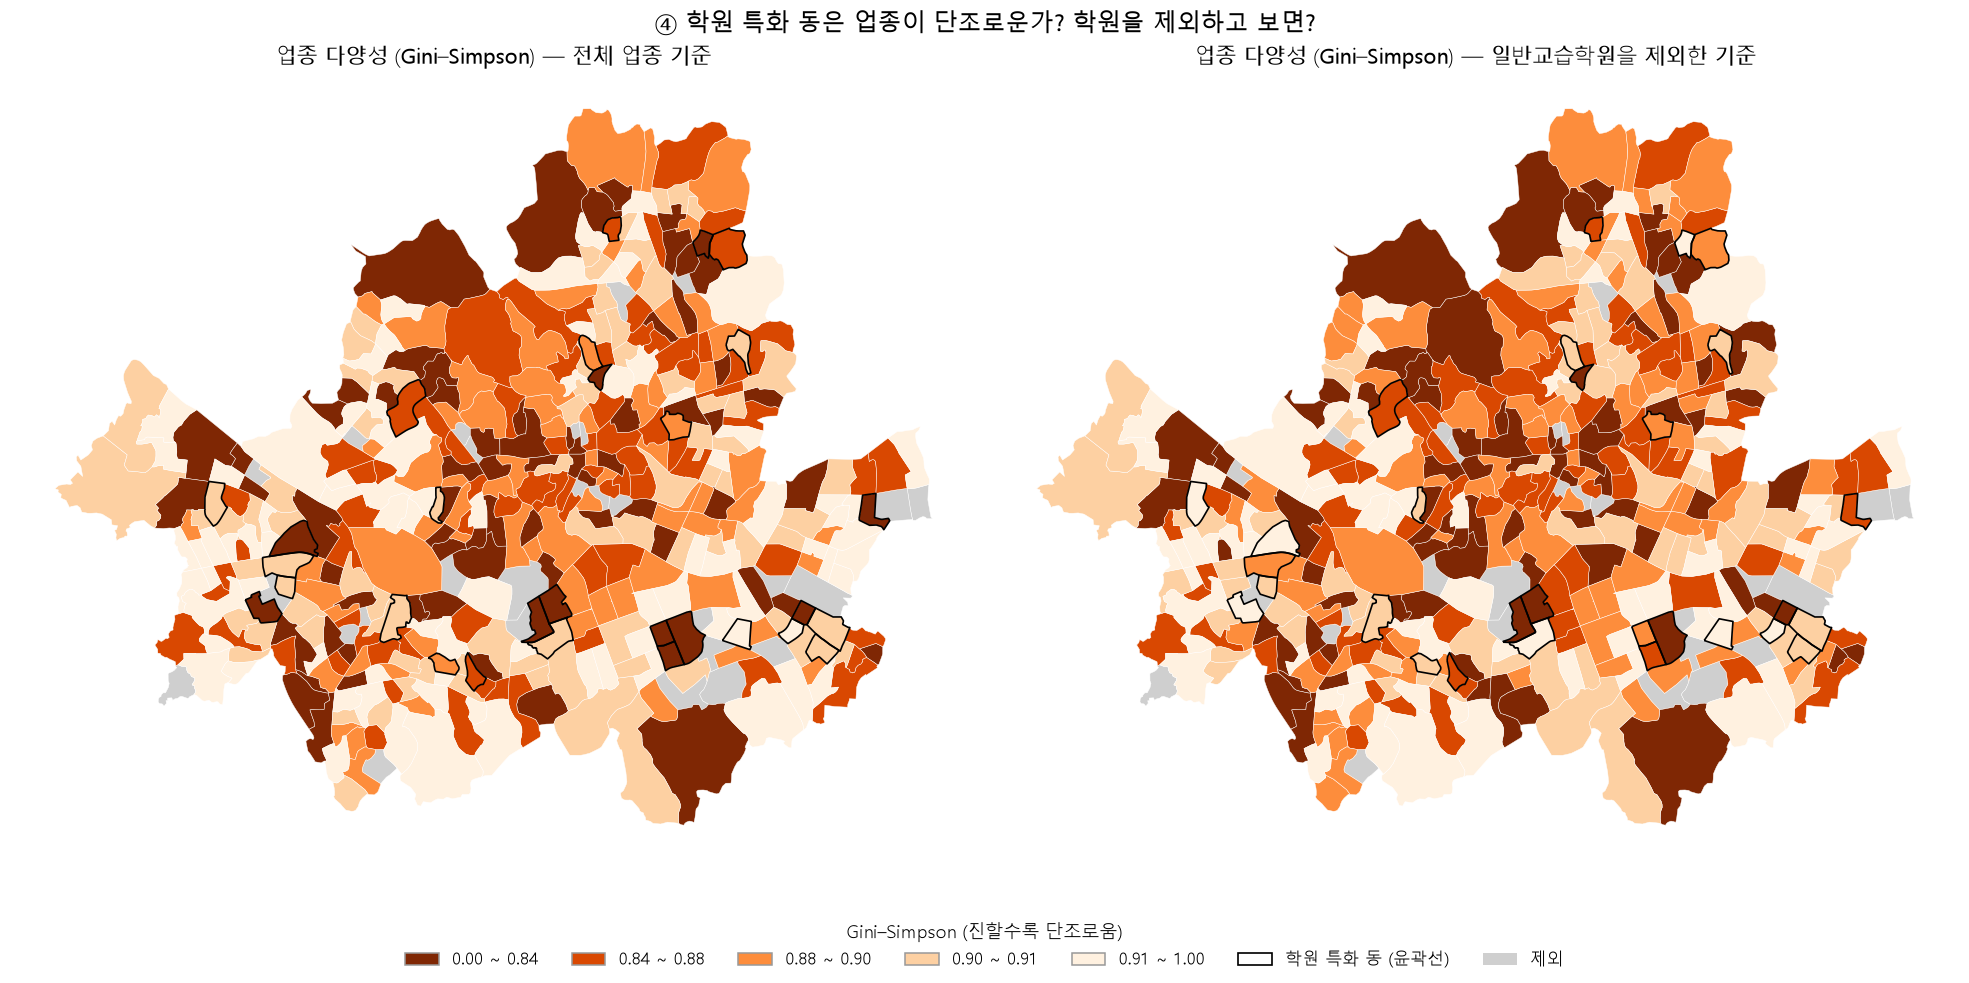
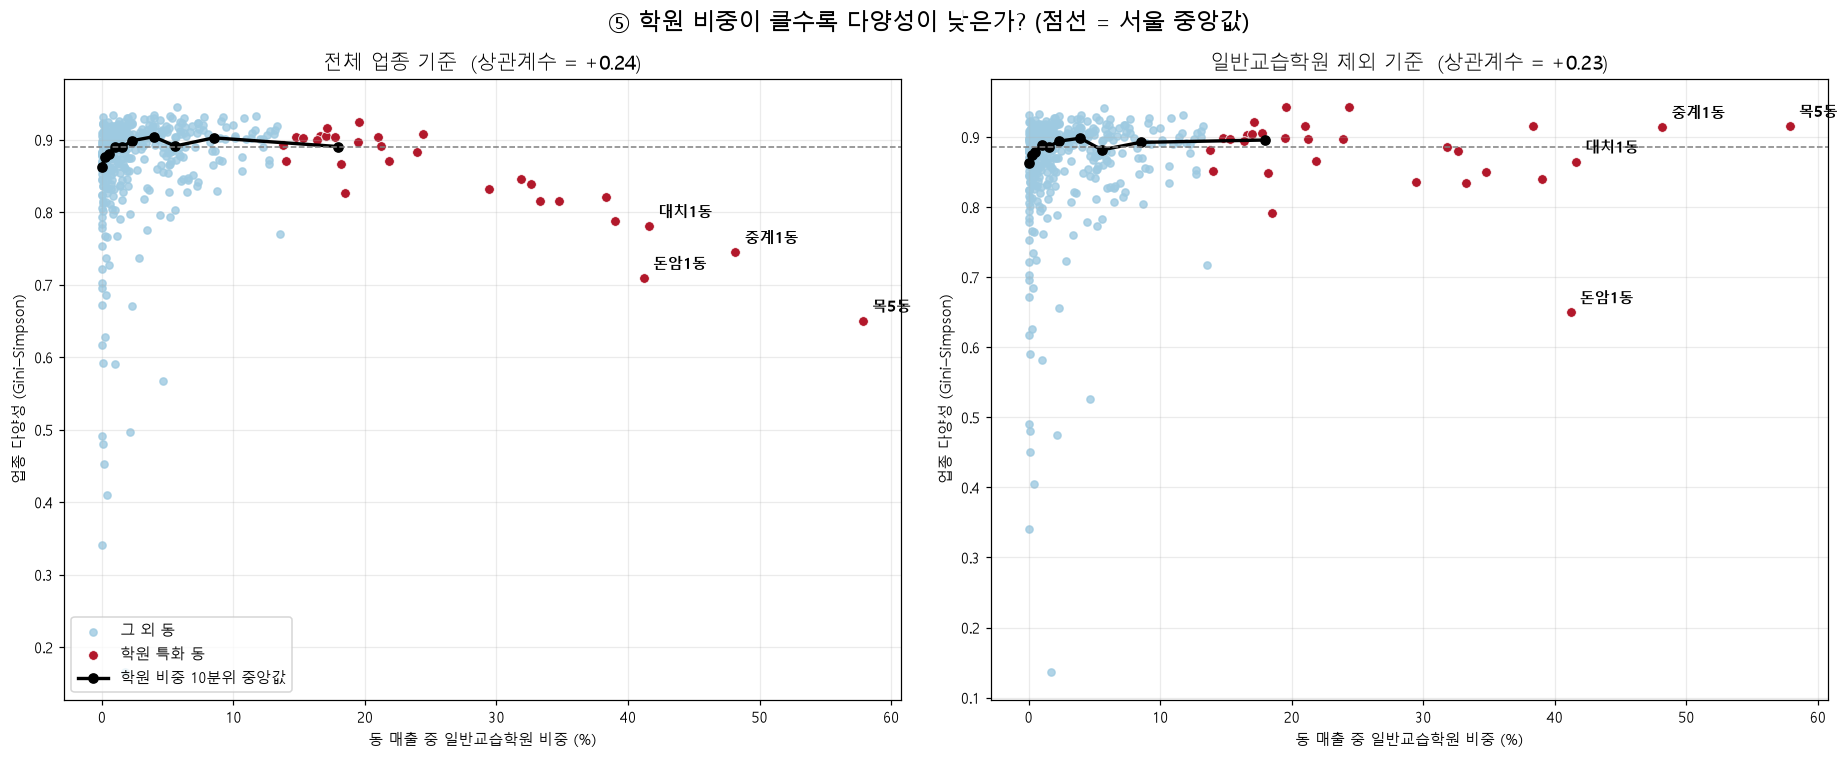
③ 학원가는 업종이 단조로운가학원을 포함하면 다소 낮고, 제외하면 차이가 거의 없다Gini–Simpson 중앙값 학원 특화 동 0.871 대 그 외 동 0.890. 학원 제외 시 0.896 대 0.885
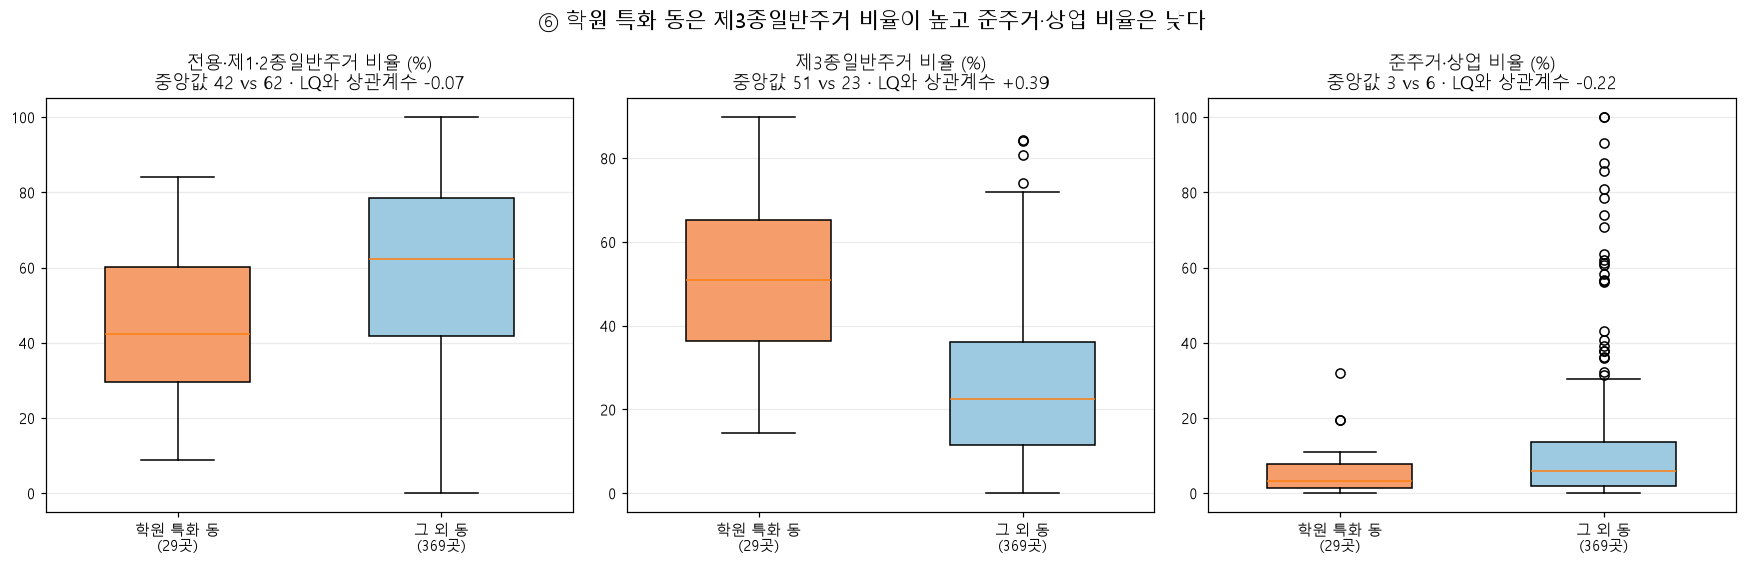
④ 학원가는 어떤 토지이용 위에 있는가준주거·상업지역이 아니라 주거지역, 그중에서도 제3종일반주거(중·고층 주택 중심)제3종일반주거 비율 중앙값 51% 대 23%, LQ와의 상관계수 +0.39. 전용·제1·2종일반주거와는 상관이 없음(−0.07)

시사점

한계: 추정 매출, 점포 소재지 기준, 한 분기의 단면, 인과관계가 아닌 상관관계

1. 연구 질문과 분석 대상

연구 질문

학원가는 도시의 다양성이 낮을까?

여기서 도시의 다양성은 동네 상권의 업종 다양성, 즉 매출이 여러 업종에 고르게 나뉘어 있는 정도를 뜻한다. 학원가는 학원이 서울 평균보다 두드러지게 몰린 동("학원 특화 동")으로 정의한다. 이 질문을 세 가지로 나누어 확인한다.

  1. 분포: 학원은 서울 어디에 몰려 있는가? (학원 입지계수 LQ, 학생 1인당 학원 매출)
  2. 다양성: 학원이 몰린 동네는 업종이 단조로운가? 학원을 제외하고 보아도 그런가? (Gini–Simpson 지수)
  3. 도시 구조: 학원가는 어떤 토지이용 위에 있는가? (용도지역 비율)

왜 이 질문인가. 학원가는 흔히 학원만 가득한 단조로운 동네로 여겨진다. 이 인상이 맞는지, 맞다면 학원 때문인지 학원 외 상권도 약한 것인지를 도시 지표로 측정해 확인하려고 한다.

항목내용
공간 범위서울특별시 행정동. 매출이 있는 업종이 20개 이상인 400개 동을 분석하고, 2025년 경계와 맞는 398개 동을 지도로 나타냄
시간 범위2026년 2분기(매출), 2026년 4~6월 평일 평균(생활인구)
"학원"의 정의상권분석서비스의 일반교습학원 업종. 한국표준산업분류의 '일반 교과학원'에 해당하며, 국어·수학 등 교과 중심의 입시·보습 학원이다
학원가의 정의"학원 특화 동": 학원 비중이 서울 평균의 1.5배(LQ 1.5) 이상이면서 서울 평균보다 10%p 이상 높은 동(29곳)
공간 단위행정동

학원을 일반교습학원 하나로 한정한 이유: 일반교습이 학원 4개 업종(일반교습·외국어·예술·스포츠 강습) 매출의 73%를 차지하고 결제자의 92%가 40~50대(학부모 연령)이기 때문이다(모두 2025년 기준). 외국어·예술학원을 합친 3개 업종으로 계산한 학원 밀도와도 동 사이 순위가 거의 같았다(상관계수 0.93).

2. 사용 자료와 전처리

자료출처내용용도
상권분석서비스 추정매출(행정동)서울 열린데이터광장, 서울신용보증재단행정동 × 업종(63개 생활밀착 업종) × 분기별 추정 매출액. 2026년 2분기 사용학원 비중(LQ), 학원 밀도의 분자, 다양성
행정동별 연령별 생활인구(내국인)서울 열린데이터광장 생활인구행정동 × 시간대(3시간 간격) × 연령대. 0~9세, 10~14세, 15~19세 사용학원 밀도의 분모
행정동 경계수업 자료(6강) HangJeongDong_ver20250101.geojson2025년 1월 기준 행정동 폴리곤지도, 이웃 관계, 용도지역 겹침
용도지역(도시지역)도시계획정보서비스(UPIS) UPIS_C_UQ111 (2026.09)전용·일반주거, 준주거, 상업, 공업(준공업)지역 폴리곤도시 구조와의 연결(보조 변수)

전처리 과정

  1. 업종과 기간: 63개 업종의 2026년 2분기 매출을 동 × 업종 표로 만들었다. 매출이 0인 항목은 제외했다.
  2. 불안정한 동 제외: 매출이 있는 업종이 20개 미만인 동은 점포 하나만 바뀌어도 비중이 크게 흔들리므로 제외했다. 400개 동이 남는다.
  3. 0~19세 생활인구: 월별 자료(2026년 4~6월)의 평일 평균을 일수로 가중평균하고, 0~9세, 10~14세, 15~19세를 더했다. 하루 8개 시간대의 평균이라 학교에 있는 시간도 포함된다. 생활인구가 500명 미만인 동은 분모가 작아 학원 밀도 계산에서 제외했다(391개 동).
  4. 결합: 매출은 8자리 행정동 코드를, 경계 파일은 10자리 adm_cd2를 쓰므로 앞 8자리로 맞췄다.
  5. 용도지역: 용도지역 폴리곤을 서로 겹치지 않는 네 구분으로 묶고, 행정동과 겹치는 면적을 계산했다.
    • 전용·제1·2종일반주거: 제1·2종전용주거지역, 제1·2종일반주거지역(자료의 '제2종일반주거지역(7층이하)'와 세분이 지정되지 않은 '일반주거지역' 포함)
    • 제3종일반주거: 제3종일반주거지역
    • 준주거·상업: 준주거지역, 중심·일반·근린·유통상업지역
    • 공업: 자료상 준공업지역
    • 비율은 네 구분의 면적 합(시가지) 대비다. 녹지지역과 그 밖의 도시지역은 제외했다.
코드 보기
import numpy as np
import pandas as pd
import geopandas as gpd
import glob
import matplotlib.pyplot as plt
import matplotlib.patheffects as pe
from matplotlib.patches import Patch
from scipy.stats import spearmanr   # 순위 기준 상관계수 계산에만 사용

plt.rc("font", family="Malgun Gothic")
plt.rc("axes", unicode_minus=False)
pd.set_option("display.width", 200)

ACADEMY = "일반교습학원"   # 청소년 입시·보습 학원의 대표 업종 (한국표준산업분류 '일반 교과학원'에 해당)
N_IND = 63                # 상권분석서비스 생활밀착 업종 수
MIN_IND = 20              # 매출이 있는 업종이 이보다 적은 동은 제외
계산 결과 출력 보기
분석 행정동: 400 | 업종: 63 | 생활인구 자료 동: 424
서울 일반교습학원 매출 9,173억 원 (분기), 전체 매출 중 3.58%
코드 보기
# 2026년 2분기 동 x 업종 매출 (서울 열린데이터광장 상권분석서비스 추정매출, 행정동)
sales = pd.read_csv("data/seoul_sales_dong_2026q2.csv")
sales = sales[sales["THSMON_SELNG_AMT"] > 0]
A = sales.pivot_table(index="ADSTRD_CD", columns="SVC_INDUTY_CD_NM", values="THSMON_SELNG_AMT", aggfunc="sum", fill_value=0)
A = A[(A > 0).sum(axis=1) >= MIN_IND]          # 업종이 20개 이상인 동만

# 0~19세 생활인구: 2026년 4~6월 평일 평균 (월별 자료를 평일 수로 가중평균, 하루 8개 시간대 평균)
pop = pd.read_csv("data/lifepop_age0_19_2026q2.csv").set_index("ADSTRD_CD")

print("분석 행정동:", len(A), "| 업종:", A.shape[1], "| 생활인구 자료 동:", len(pop))
print(f"서울 일반교습학원 매출 {A[ACADEMY].sum() / 1e8:,.0f}억 원 (분기), 전체 매출 중 {A[ACADEMY].sum() / A.values.sum():.2%}")

3. 지표 정의, 계산식, 해석

모든 지표의 분석 단위는 행정동이고 공간 단위도 행정동이다. 기호는 다음과 같다. 동 $i$, 업종 $j$, 동 $i$의 업종 $j$ 매출 $x_{ij}$, 동 전체 매출 $x_i=\sum_j x_{ij}$, 업종 비중 $p_{ij}=x_{ij}/x_i$, 업종 수 $K=63$이다.

지표 1. 학원 입지계수 LQ: 학원은 어디에 몰려 있는가

$$LQ_i=\dfrac{x_{i,\text{학원}}/x_i}{x_{\text{학원}}/x}$$

지표 2. 학생 1인당 학원 매출(학원 밀도, Density): 학생 수에 비해 학원 매출은 어디에서 가장 큰가 (직접 설계)

$$D_i=\dfrac{x_{i,\text{학원}}}{P_i^{0\text{~}19}}\ \ (\text{만 원/인/분기})$$

지표 3. 업종 다양성 Gini–Simpson: 학원가는 업종이 단조로운가

$$D^{GS}_i=1-\sum_{j=1}^{K}p_{ij}^2,\qquad 0\le D^{GS}\le 1-\tfrac1K$$

보조 변수. 용도지역 비율: 도시 구조와의 연결

동마다 시가지 면적 대비 용도지역의 면적 비율을 계산한다. 새 지표가 아니라 위 지표를 해석하기 위한 관련 변수다. 용도지역은 서로 겹치지 않는 세 구분으로 나누며, 나머지는 공업지역(자료상 준공업지역)이다.

구분포함하는 용도지역법령상 성격
전용·제1·2종일반주거제1·2종전용주거지역, 제1·2종일반주거지역전용주거는 양호한 주거환경을 보호하는 지역(제1종은 단독주택, 제2종은 공동주택 중심). 제1종일반은 저층주택, 제2종일반은 중층주택 중심
제3종일반주거제3종일반주거지역중·고층주택 중심
준주거·상업준주거지역, 중심·일반·근린·유통상업지역준주거는 주거 기능 위주에 일부 상업·업무 기능을 보완하는 지역, 상업은 상업·업무 기능 중심
계산 결과 출력 보기
서울 평균 학원 비중 3.58% | LQ>1인 동 148곳 | LQ≥3인 동 47곳 | 학원 특화 동 29곳
       academy_share       lq  density   gs_all  gs_noac
count        400.000  400.000  391.000  400.000  400.000
mean           0.047    1.305   46.214    0.865    0.862
std            0.075    2.083   84.552    0.085    0.085
min            0.000    0.000    0.000    0.166    0.137
25%            0.005    0.142    7.952    0.856    0.852
50%            0.019    0.538   21.458    0.889    0.885
75%            0.056    1.571   47.876    0.908    0.904
max            0.579   16.151  862.073    0.945    0.943
코드 보기
def gini_simpson(M):
    """Gini-Simpson 지수 D = 1 - sum(p_k^2): 무작위로 고른 두 결제가 서로 다른 업종일 확률"""
    P = M.div(M.sum(axis=1), axis=0)
    return 1 - (P ** 2).sum(axis=1)

def entropy(M):
    P = M.div(M.sum(axis=1), axis=0).values
    return pd.Series(-np.nansum(np.where(P > 0, P * np.log(P), 0), axis=1) / np.log(N_IND), index=M.index)

ind = pd.DataFrame(index=A.index)
ind["academy_amt"] = A[ACADEMY]
ind["academy_share"] = A[ACADEMY] / A.sum(axis=1)
seoul_share = A[ACADEMY].sum() / A.values.sum()
ind["lq"] = ind["academy_share"] / seoul_share                               # 지표 1. 입지계수
ind["pop_0_19"] = pop["pop_0_19"].reindex(ind.index)
ind["density"] = np.where(ind["pop_0_19"] >= 500, ind["academy_amt"] / ind["pop_0_19"] / 1e4, np.nan)   # 지표 2. 학원 밀도 (만원/인/분기)
ind["gs_all"] = gini_simpson(A)                                              # 지표 3. 다양성 (전체 업종)
ind["gs_noac"] = gini_simpson(A.drop(columns=ACADEMY))                       #         (학원 제외)
ind["ent_all"] = entropy(A)                                                  # 강건성 확인용
ind["ent_noac"] = entropy(A.drop(columns=ACADEMY))
ind["ac_town"] = (ind["lq"] >= 1.5) & (ind["academy_share"] - seoul_share >= 0.10)   # 학원 특화 동

print(f"서울 평균 학원 비중 {seoul_share:.2%} | LQ>1인 동 {int((ind['lq'] > 1).sum())}곳 | LQ≥3인 동 {int((ind['lq'] >= 3).sum())}곳 | 학원 특화 동 {int(ind['ac_town'].sum())}곳")
print(ind[["academy_share", "lq", "density", "gs_all", "gs_noac"]].describe().round(3).to_string())
계산 결과 출력 보기
경계 행정동: 426 | 분석 동(경계와 결합): 398 | 지도에서 회색(제외·자료 없음): 28
분석 400개 동 중 경계와 맞지 않아 지도에서 빠지는 동: 2개
코드 보기
# 행정동 경계(2025년 1월 기준)와 결합
gj = gpd.read_file("../lecture06_Living_Population/data/HangJeongDong_ver20250101.geojson")
gj = gj[gj["sidonm"] == "서울특별시"].copy()
gj["ADSTRD_CD"] = gj["adm_cd2"].str[:8].astype(int)
gj["dong_nm"] = gj["adm_nm"].str.split().str[-1]
gj = gj.to_crs(epsg=5179)
gdf = gj.merge(ind, left_on="ADSTRD_CD", right_index=True, how="left")
gdf["valid"] = gdf["lq"].notna()
ind2 = ind.join(gj.drop_duplicates("ADSTRD_CD").set_index("ADSTRD_CD")[["dong_nm", "sggnm"]]).dropna(subset=["dong_nm"])
print("경계 행정동:", len(gj), "| 분석 동(경계와 결합):", int(gdf["valid"].sum()), "| 지도에서 회색(제외·자료 없음):", int((~gdf["valid"]).sum()))
print(f"분석 {len(ind)}개 동 중 경계와 맞지 않아 지도에서 빠지는 동: {len(ind) - int(gdf['valid'].sum())}개")

4. 결과

4-1. 학원은 서울 어디에 몰려 있는가 (LQ)

서울 전체 매출에서 일반교습학원은 3.58%다. 학원 비중이 서울 평균보다 높은 동(LQ > 1)은 148곳, LQ가 3 이상인 동은 47곳, 학원 특화 동은 29곳이다.

계산 결과 출력 보기
LQ 상위 8: 목5동 16.2, 중계1동 13.4, 대치1동 11.6, 돈암1동 11.5, 반포2동 10.9, 신정7동 10.7, 명일2동 9.7, 방이1동 9.3
그림 1
코드 보기
# 그림 1 (공간) 학원 입지계수(LQ): 학원은 어디에 몰려 있는가
bins = [0, 1, 1.5, 3, np.inf]
labels = ["< 1 (서울 평균 이하)", "1 ~ 1.5", "1.5 ~ 3", "≥ 3 (강한 집중)"]
colors = ["#f1f1f1", "#fde0c5", "#f59e6c", "#b2182b"]
g = gdf.copy()
g["cls"] = pd.cut(g["lq"], bins=bins, labels=False, right=False)
fig, ax = plt.subplots(figsize=(11, 10))
g[~g["valid"]].plot(ax=ax, color="#cfcfcf", edgecolor="white", linewidth=0.3)
for k, c in enumerate(colors):
    g[g["cls"] == k].plot(ax=ax, color=c, edgecolor="white", linewidth=0.3)
g[g["ac_town"] == True].boundary.plot(ax=ax, color="#4a0d14", linewidth=1.3)
halo = [pe.withStroke(linewidth=3, foreground="white")]
top_lq = g[g["ac_town"] == True].sort_values("lq", ascending=False).head(6)
offs = [(-6000, 4500), (3000, 6500), (-5500, 7000), (-5000, 6500), (5500, -6500), (-7000, -5500)]
for (_, r), (dx, dy) in zip(top_lq.iterrows(), offs):
    x, y = r.geometry.centroid.x, r.geometry.centroid.y
    ax.annotate(r["dong_nm"], (x, y), (x + dx, y + dy), fontsize=10.5, fontweight="bold", path_effects=halo,
                arrowprops=dict(arrowstyle="-", color="#444", lw=0.8))
ax.legend(handles=[Patch(facecolor=c, edgecolor="#999", label=l) for c, l in zip(colors, labels)]
          + [Patch(facecolor="none", edgecolor="#4a0d14", linewidth=1.3, label=f"학원 특화 동 ({int(ind['ac_town'].sum())}개)"),
             Patch(facecolor="#cfcfcf", label="제외 (업종 20개 미만 등)")],
          title="일반교습학원 입지계수 (LQ)", loc="upper left", fontsize=10, title_fontsize=11)
ax.set_title("① 학원은 서울 어디에 몰려 있는가 (행정동 학원 입지계수, 2026년 2분기)", fontsize=15)
ax.set_axis_off()
plt.subplots_adjust(0.02, 0.02, 0.98, 0.95)
plt.savefig("image/academy3_fig1_lq_map.png", dpi=150)
plt.show()
print("LQ 상위 8:", ", ".join(f"{r.dong_nm} {r.lq:.1f}" for r in ind2.sort_values("lq", ascending=False).head(8).itertuples()))

4-2. 학생 1인당 학원 매출은 어디에서 가장 큰가 (학원 밀도)

계산 결과 출력 보기
학원 밀도: 서울 전체 60만 원/인, 동 중앙값 22만 원
밀도 상위 8: 노량진2동 862, 대치4동 588, 명일2동 588, 대치2동 477, 대치1동 383, 반포3동 338, 방이1동 328, 신정7동 324
그림 2
코드 보기
# 그림 2 (공간) 학원 밀도: 학생 1인당 학원 매출
bins = [0, 10, 22, 50, 150, np.inf]
labels = ["< 10만 원", "10 ~ 22 (서울 중앙값 이하)", "22 ~ 50", "50 ~ 150", "≥ 150만 원 (강한 집중)"]
colors = ["#f1f1f1", "#fde0c5", "#fdae6b", "#e6550d", "#7f2704"]
med = ind2["density"].median()
g = gdf.copy()
g["cls"] = pd.cut(g["density"], bins=bins, labels=False, right=False)
fig, ax = plt.subplots(figsize=(11, 10))
g[g["density"].isna()].plot(ax=ax, color="#cfcfcf", edgecolor="white", linewidth=0.3)
for k, c in enumerate(colors):
    g[g["cls"] == k].plot(ax=ax, color=c, edgecolor="white", linewidth=0.3)
g[g["ac_town"] == True].boundary.plot(ax=ax, color="#4a0d14", linewidth=1.1)
top = g.sort_values("density", ascending=False).head(4)
offs = [(-9000, -6000), (-3500, -9500), (-8500, 8500), (-1500, 10500)]
for (_, r), (dx, dy) in zip(top.iterrows(), offs):
    x, y = r.geometry.centroid.x, r.geometry.centroid.y
    ax.annotate(f"{r['dong_nm']} {r['density']:.0f}만", (x, y), (x + dx, y + dy), fontsize=10.5, fontweight="bold", path_effects=halo,
                arrowprops=dict(arrowstyle="-", color="#444", lw=0.8))
ax.legend(handles=[Patch(facecolor=c, edgecolor="#999", label=l) for c, l in zip(colors, labels)]
          + [Patch(facecolor="none", edgecolor="#4a0d14", linewidth=1.1, label="학원 특화 동 (윤곽선)"), Patch(facecolor="#cfcfcf", label="제외·자료 없음")],
          title="학생(0~19세) 1인당 학원 매출 (분기)", loc="upper left", fontsize=10, title_fontsize=11)
ax.set_title("② 학생 1인당 학원 매출은 어디에서 가장 큰가 (학원 밀도, 2026년 2분기)", fontsize=15)
ax.set_axis_off()
plt.subplots_adjust(0.02, 0.02, 0.98, 0.95)
plt.savefig("image/academy3_fig2_density_map.png", dpi=150)
plt.show()
print(f"학원 밀도: 서울 전체 {ind2['academy_amt'].sum() / ind2['pop_0_19'].sum() / 1e4:.0f}만 원/인, 동 중앙값 {med:.0f}만 원")
print("밀도 상위 8:", ", ".join(f"{r.dong_nm} {r.density:.0f}" for r in ind2.sort_values("density", ascending=False).head(8).itertuples()))
계산 결과 출력 보기
LQ와 밀도의 상관계수(순위 기준) = +0.83
학원 특화 동의 밀도 중앙값 157만 vs 그 외 19만
LQ 상위 5동의 밀도(만원): 목5동 LQ 16.2 / 301, 중계1동 LQ 13.4 / 63, 대치1동 LQ 11.6 / 383, 돈암1동 LQ 11.5 / 167, 반포2동 LQ 10.9 / 143
밀도 상위 5동의 LQ: 노량진2동 862만 / LQ 0.5, 대치4동 588만 / LQ 9.1, 명일2동 588만 / LQ 9.7, 대치2동 477만 / LQ 8.2, 대치1동 383만 / LQ 11.6
그림 3
코드 보기
# 그림 6 (비공간) 두 지표 나란히: 학원 비중(LQ) vs 학원 밀도
dd = ind2.dropna(subset=["density"])
fig, ax = plt.subplots(figsize=(11, 8))
ax.scatter(dd.loc[~dd["ac_town"], "lq"], dd.loc[~dd["ac_town"], "density"], s=22, color="#9ecae1", alpha=0.8, label="그 외 동")
ax.scatter(dd.loc[dd["ac_town"], "lq"], dd.loc[dd["ac_town"], "density"], s=45, color="#b2182b", edgecolor="white", linewidth=0.5, label="학원 특화 동")
ax.set_xscale("symlog", linthresh=1); ax.set_yscale("log")
ax.axvline(1, color="gray", ls="--", lw=1); ax.axhline(dd["density"].median(), color="gray", ls="--", lw=1)
ax.set_xlabel("학원 입지계수 LQ (동 매출 속 비중, 1 = 서울 평균)"); ax.set_ylabel("학원 밀도 (학생 1인당 학원 매출, 만 원/분기, 로그)")
lab = pd.concat([dd.nlargest(6, "density"), dd.nlargest(6, "lq")]).drop_duplicates()
OFF = {"노량진2동": (8, 4, "left"), "대치4동": (-8, 8, "right"), "명일2동": (8, 8, "left"), "대치2동": (-8, 4, "right"), "대치1동": (8, 4, "left"),
       "반포3동": (-8, 6, "right"), "목5동": (8, 6, "left"), "중계1동": (8, -12, "left"), "돈암1동": (8, 6, "left"), "반포2동": (8, -14, "left"),
       "신정7동": (8, -10, "left"), "방이1동": (-8, -12, "right")}
for r in lab.itertuples():
    dx, dy, ha = OFF.get(r.dong_nm, (6, 4, "left"))
    ax.annotate(r.dong_nm, (r.lq, r.density), (dx, dy), textcoords="offset points", ha=ha, fontsize=10, fontweight="bold", path_effects=halo)
ax.set_title("③ 학원 '비중'(LQ)과 '학생 1인당 학원 매출'은 같은 동네를 가리키는가", fontsize=14)
ax.grid(alpha=0.25); ax.legend(loc="lower right")
plt.tight_layout()
plt.savefig("image/academy3_fig3_lq_density.png", dpi=150)
plt.show()
print(f"LQ와 밀도의 상관계수(순위 기준) = {spearmanr(dd['lq'], dd['density'])[0]:+.2f}")
print("학원 특화 동의 밀도 중앙값 %.0f만 vs 그 외 %.0f만" % (dd[dd.ac_town].density.median(), dd[~dd.ac_town].density.median()))
print("LQ 상위 5동의 밀도(만원):", ", ".join(f"{r.dong_nm} LQ {r.lq:.1f} / {r.density:.0f}" for r in dd.nlargest(5, "lq").itertuples()))
print("밀도 상위 5동의 LQ:", ", ".join(f"{r.dong_nm} {r.density:.0f}만 / LQ {r.lq:.1f}" for r in dd.nlargest(5, "density").itertuples()))
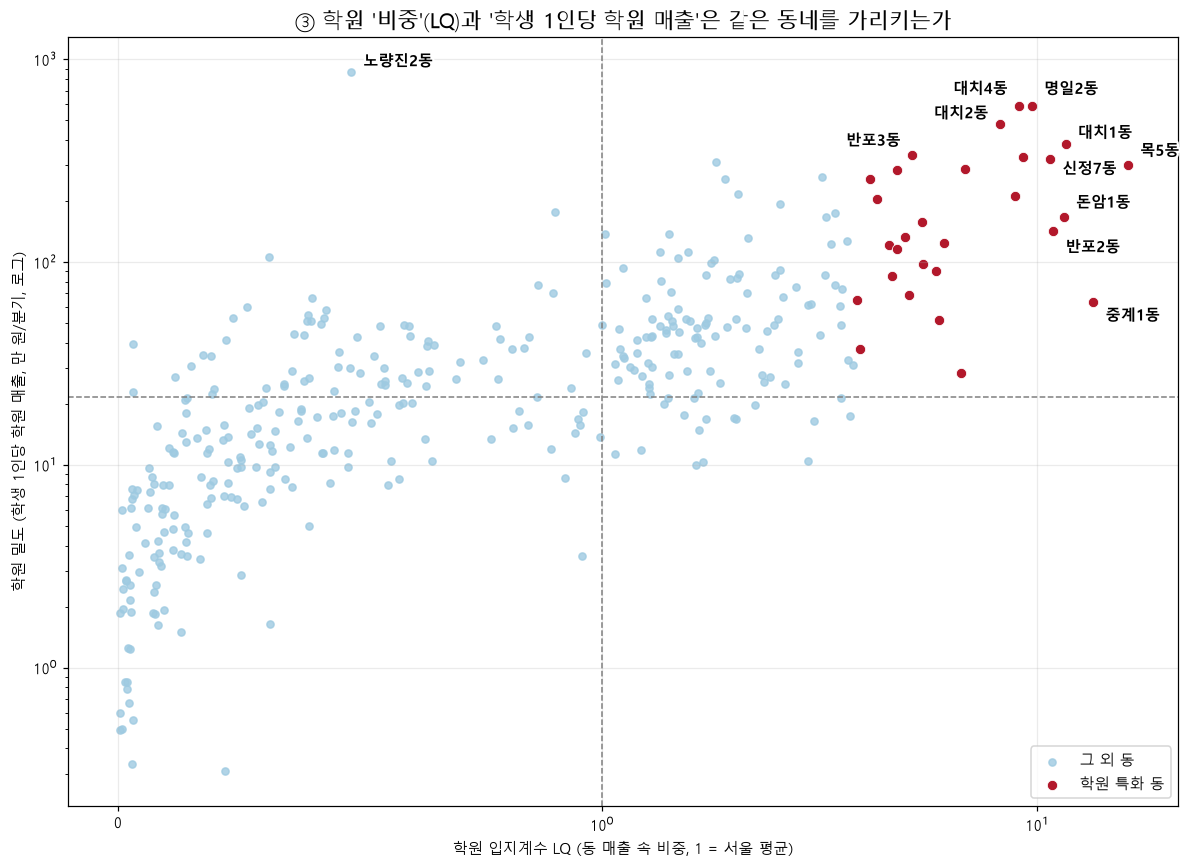
LQ와 밀도는 같은 동네를 가리키는가. 두 지표의 상관계수는 +0.83으로 매우 높다. 학원 특화 동의 밀도 중앙값은 157만 원으로 그 외 동 19만 원의 약 8배다. 학원 비중이 큰 동네는 학생 수에 비해서도 학원 매출이 크다.

다만 두 지표가 갈리는 동이 있어서 서로 다른 정보를 준다.

4-3. 학원가는 업종이 단조로운가: 공간 패턴

두 지도는 색 구간을 같게 맞췄다. 왼쪽은 63개 업종 전체, 오른쪽은 일반교습학원을 제외한 업종으로 계산한 Gini–Simpson 지수이고, 검은 윤곽선이 학원 특화 동이다.

그림 4
코드 보기
# 그림 3 (공간) 업종 다양성(Gini–Simpson): 전체 업종 vs 학원 제외 (같은 색 구간)
vals = pd.concat([gdf["gs_all"], gdf["gs_noac"]]).dropna()
edges = np.quantile(vals, [0, .2, .4, .6, .8, 1.0]); edges[0], edges[-1] = 0, 1
cmap = ["#7f2704", "#d94801", "#fd8d3c", "#fdd0a2", "#fff1e0"]
cls_labels = [f"{edges[i]:.2f} ~ {edges[i + 1]:.2f}" for i in range(5)]
fig, axes = plt.subplots(1, 2, figsize=(18, 9))
for ax, col, title in [(axes[0], "gs_all", "전체 업종 기준"), (axes[1], "gs_noac", "일반교습학원을 제외한 기준")]:
    g = gdf.copy()
    g["cls"] = pd.cut(g[col], bins=edges, labels=False, include_lowest=True)
    g[~g["valid"]].plot(ax=ax, color="#cfcfcf", edgecolor="white", linewidth=0.3)
    for k, c in enumerate(cmap):
        g[g["cls"] == k].plot(ax=ax, color=c, edgecolor="white", linewidth=0.3)
    g[g["ac_town"] == True].boundary.plot(ax=ax, color="black", linewidth=1.1)
    ax.set_title(f"업종 다양성 (Gini–Simpson) — {title}", fontsize=14); ax.set_axis_off()
fig.legend(handles=[Patch(facecolor=c, edgecolor="#999", label=l) for c, l in zip(cmap, cls_labels)]
           + [Patch(facecolor="none", edgecolor="black", linewidth=1.1, label="학원 특화 동 (윤곽선)"), Patch(facecolor="#cfcfcf", label="제외")],
           title="Gini–Simpson (진할수록 단조로움)", loc="lower center", ncol=7, fontsize=11, title_fontsize=12, frameon=False)
fig.suptitle("④ 학원 특화 동은 업종이 단조로운가? 학원을 제외하고 보면?", fontsize=16)
plt.tight_layout(rect=(0, 0.08, 1, 1))
plt.savefig("image/academy3_fig4_gs_maps.png", dpi=150)
plt.show()

4-4. 학원 비중과 업종 다양성의 관계

비교 (중앙값)학원 특화 동 29곳그 외 동
Gini–Simpson, 전체 업종0.8710.890
Gini–Simpson, 학원 제외0.8960.885
Entropy, 전체 업종 (강건성)0.6200.651
Entropy, 학원 제외 (강건성)0.6480.638
계산 결과 출력 보기
전체 업종: 학원 특화 동 중앙값 0.871 vs 그 외 0.890
학원 제외: 학원 특화 동 중앙값 0.896 vs 그 외 0.885
엔트로피(전체): 학원 특화 동 중앙값 0.620 vs 그 외 0.651
엔트로피(학원 제외): 학원 특화 동 중앙값 0.648 vs 그 외 0.638
학원 특화 동 29곳 중 지니심슨(전체)이 서울 중앙값보다 낮은 동: 16곳
그림 5
코드 보기
# 그림 4 (비공간) 학원 비중과 업종 다양성의 관계
fig, axes = plt.subplots(1, 2, figsize=(17, 7), sharex=True)
sel = ind2["ac_town"]
for ax, col, title in [(axes[0], "gs_all", "전체 업종 기준"), (axes[1], "gs_noac", "일반교습학원 제외 기준")]:
    ax.scatter(ind2.loc[~sel, "academy_share"] * 100, ind2.loc[~sel, col], s=22, color="#9ecae1", alpha=0.8, label="그 외 동")
    ax.scatter(ind2.loc[sel, "academy_share"] * 100, ind2.loc[sel, col], s=40, color="#b2182b", edgecolor="white", linewidth=0.5, label="학원 특화 동")
    q = pd.qcut(ind2["academy_share"], 10, duplicates="drop")
    mid = ind2.groupby(q, observed=True).agg(x=("academy_share", "median"), y=(col, "median"))
    ax.plot(mid["x"] * 100, mid["y"], color="black", lw=2.2, marker="o", label="학원 비중 10분위 중앙값")
    rho = spearmanr(ind2["academy_share"], ind2[col])[0]
    ax.set_title(f"{title}  (상관계수 = {rho:+.2f})", fontsize=13)
    ax.set_xlabel("동 매출 중 일반교습학원 비중 (%)"); ax.set_ylabel("업종 다양성 (Gini–Simpson)")
    ax.axhline(ind2[col].median(), color="gray", ls="--", lw=1); ax.grid(alpha=0.25)
    for r in ind2[ind2["ac_town"]].sort_values("lq", ascending=False).head(4).itertuples():
        ax.annotate(r.dong_nm, (r.academy_share * 100, getattr(r, col)), (6, 6), textcoords="offset points", fontsize=10, fontweight="bold")
axes[0].legend(loc="lower left")
fig.suptitle("⑤ 학원 비중이 클수록 다양성이 낮은가? (점선 = 서울 중앙값)", fontsize=15)
plt.tight_layout()
plt.savefig("image/academy3_fig5_scatter.png", dpi=150)
plt.show()
town, rest = ind2[ind2["ac_town"]], ind2[~ind2["ac_town"]]
for lab, col in [("전체 업종", "gs_all"), ("학원 제외", "gs_noac"), ("엔트로피(전체)", "ent_all"), ("엔트로피(학원 제외)", "ent_noac")]:
    print(f"{lab}: 학원 특화 동 중앙값 {town[col].median():.3f} vs 그 외 {rest[col].median():.3f}")
print(f"학원 특화 동 {len(town)}곳 중 지니심슨(전체)이 서울 중앙값보다 낮은 동: {int((town['gs_all'] < ind2['gs_all'].median()).sum())}곳")

4-5. 학원가는 어떤 토지이용 위에 있는가 (용도지역)

용도지역 비율 (시가지 대비, 중앙값)학원 특화 동그 외 동LQ와의 상관계수학원 밀도와의 상관계수
전용·제1·2종일반주거42%62%−0.07−0.16
제3종일반주거51%23%+0.39+0.34
준주거·상업3%6%−0.22−0.04
계산 결과 출력 보기
용도지역과 결합된 동 398 | 시가지(전용·일반주거+준주거+상업+공업) 면적 대비 비율
서울 동 중앙값(%): {'전용·제1·2종일반주거': 60, '제3종일반주거': 24, '준주거·상업': 5}

[학원 특화 동 vs 그 외] 중앙값(%)
  전용·제1·2종일반주거: 42 vs 62
  제3종일반주거: 51 vs 23
  준주거·상업: 3 vs 6

[상관계수(순위 기준)]        LQ    학원 밀도   지니심슨(전체)  지니심슨(학원 제외)
  전용·제1·2종일반주거 -0.07   -0.16      +0.08          +0.04
  제3종일반주거    +0.39   +0.34      +0.08          +0.11
  준주거·상업     -0.22   -0.04      -0.00          +0.02

[유형별] 동 수 / 학원 특화 동 수 / LQ 중앙값
                   동  학원특화동  LQ중앙값
type                              
전용·일반주거 합계 70%↑  338     28   0.60
준주거·상업 40%↑       19      0   0.00
혼합                41      1   0.22
전용·일반주거 합계와 준주거·상업 비율의 상관(서로 반대로 움직이는 정도): -0.83
학원 LQ 상위 6동의 전용·제1·2종 / 제3종 / 준주거·상업 (%): 목5동 23/62/10, 중계1동 14/76/10, 대치1동 28/72/1, 돈암1동 33/65/2, 반포2동 28/72/0, 신정7동 39/52/6
학원 특화 동의 전용·일반주거 합계 최소 68%, 중앙값 97%
학원 특화 동의 공업지역 비율 중앙값 0%, 그 외 동 0%
지정 면적(㎢): 전용·제1·2종일반주거 214, 제3종일반주거 101, 준주거·상업 41, 공업 20
코드 보기
# 보조 변수: 용도지역 비율 (도시 구조·토지이용과의 연결용)
z = gpd.read_file(glob.glob("shp/569_UQ111_용도지역(도시지역)_202609/*.shp")[0], encoding="cp949").to_crs(5179)
z = z[z["ATRB_SE"].notna()].copy(); z["geometry"] = z.geometry.make_valid()
def zone_cls(c):
    if c.startswith("UQA11") or c in ("UQA121", "UQA122", "UQA124", "UQA129"): return "전용·제1·2종일반주거"
    if c == "UQA123": return "제3종일반주거"
    if c in ("UQA130", "UQA190") or c.startswith("UQA2"): return "준주거·상업"
    if c.startswith("UQA3"): return "공업"
    return None
z["cls"] = z["ATRB_SE"].map(zone_cls); z = z[z["cls"].notna()]
zd = z.dissolve(by="cls").reset_index()[["cls", "geometry"]]
ov = gpd.overlay(gj[["ADSTRD_CD", "geometry"]], zd, how="intersection", keep_geom_type=True)
ov["area"] = ov.geometry.area
ar = ov.pivot_table(index="ADSTRD_CD", columns="cls", values="area", aggfunc="sum", fill_value=0)
K = ["전용·제1·2종일반주거", "제3종일반주거", "준주거·상업", "공업"]
for c in K:
    if c not in ar.columns: ar[c] = 0
urban = ar[K].sum(axis=1)
Z = (ar[K[:3]].div(urban, axis=0))[urban > 0]   # 서로 겹치지 않는 3개 구분 (나머지는 공업지역)
d = ind2.join(Z, how="inner")
print(f"용도지역과 결합된 동 {len(d)} | 시가지(전용·일반주거+준주거+상업+공업) 면적 대비 비율")
print("서울 동 중앙값(%):", {c: round(d[c].median() * 100) for c in Z.columns})
print("\n[학원 특화 동 vs 그 외] 중앙값(%)")
for c in Z.columns:
    t, r = d[d["ac_town"]][c], d[~d["ac_town"]][c]
    print(f"  {c}: {t.median() * 100:.0f} vs {r.median() * 100:.0f}")
print("\n[상관계수(순위 기준)]        LQ    학원 밀도   지니심슨(전체)  지니심슨(학원 제외)")
for c in Z.columns:
    print(f"  {c:<10} {spearmanr(d.lq, d[c])[0]:+.2f}   {spearmanr(d.dropna(subset=['density']).density, d.dropna(subset=['density'])[c])[0]:+.2f}      {spearmanr(d.gs_all, d[c])[0]:+.2f}          {spearmanr(d.gs_noac, d[c])[0]:+.2f}")
d["주거합계"] = d["전용·제1·2종일반주거"] + d["제3종일반주거"]
d["type"] = np.where(d["주거합계"] >= 0.7, "전용·일반주거 합계 70%↑", np.where(d["준주거·상업"] >= 0.4, "준주거·상업 40%↑", "혼합"))
print("\n[유형별] 동 수 / 학원 특화 동 수 / LQ 중앙값")
print(d.groupby("type").agg(동=("lq", "size"), 학원특화동=("ac_town", "sum"), LQ중앙값=("lq", "median")).round(2).to_string())
print("전용·일반주거 합계와 준주거·상업 비율의 상관(서로 반대로 움직이는 정도):", round(spearmanr(d["주거합계"], d["준주거·상업"])[0], 2))
print("학원 LQ 상위 6동의 전용·제1·2종 / 제3종 / 준주거·상업 (%):", ", ".join(f"{r.dong_nm} {r['전용·제1·2종일반주거'] * 100:.0f}/{r['제3종일반주거'] * 100:.0f}/{r['준주거·상업'] * 100:.0f}" for _, r in d.sort_values("lq", ascending=False).head(6).iterrows()))
print("학원 특화 동의 전용·일반주거 합계 최소 %.0f%%, 중앙값 %.0f%%" % (d[d["ac_town"]]["주거합계"].min() * 100, d[d["ac_town"]]["주거합계"].median() * 100))
print("학원 특화 동의 공업지역 비율 중앙값 %.0f%%, 그 외 동 %.0f%%" % ((1 - d[d["ac_town"]][list(Z.columns)].sum(axis=1)).median() * 100, (1 - d[~d["ac_town"]][list(Z.columns)].sum(axis=1)).median() * 100))
print("지정 면적(㎢): " + ", ".join(f"{k} {ar[k].sum() / 1e6:.0f}" for k in K))
그림 6
코드 보기
# 그림 5 (비공간) 학원 특화 동은 어떤 토지이용에 있는가: 용도지역 비율
fig, axes = plt.subplots(1, 3, figsize=(16, 5.2))
for ax, c in zip(axes, ["전용·제1·2종일반주거", "제3종일반주거", "준주거·상업"]):
    t, r = d[d["ac_town"]][c] * 100, d[~d["ac_town"]][c] * 100
    bp = ax.boxplot([t, r], tick_labels=[f"학원 특화 동\n({len(t)}곳)", f"그 외 동\n({len(r)}곳)"], patch_artist=True, widths=0.55)
    for patch, col in zip(bp["boxes"], ["#f59e6c", "#9ecae1"]):
        patch.set_facecolor(col)
    rho = spearmanr(d["lq"], d[c])[0]
    ax.set_title(f"{c} 비율 (%)\n중앙값 {t.median():.0f} vs {r.median():.0f} · LQ와 상관계수 {rho:+.2f}", fontsize=12)
    ax.grid(alpha=0.25, axis="y")
fig.suptitle("⑥ 학원 특화 동은 제3종일반주거 비율이 높고 준주거·상업 비율은 낮다", fontsize=14)
plt.tight_layout()
plt.savefig("image/academy3_fig6_zoning.png", dpi=150)
plt.show()

5. 종합 해석

연구 질문에 대한 답. 학원가는 도시의 다양성이 낮은가? 전체 업종으로 보면 다소 낮지만, 그것은 학원이 매출의 큰 몫을 차지하기 때문이며 학원을 제외하면 서울의 다른 동과 같다. 학원가는 단조로운 동네라기보다, 일반적인 주거 근린 상권에 학원이라는 큰 업종이 더해진 동네에 가깝다(이 마지막 표현은 추정이다). 과제가 묻는 네 가지 질문에 차례로 답한다.

① 값이 높은 곳과 낮은 곳은 어디인가

② 지표 간에 비슷하거나 다른 공간 패턴이 나타나는가

③ 관찰된 패턴을 도시 구조나 토지이용 특성과 어떻게 연결할 수 있는가

④ 분석 결과만으로는 설명할 수 없는 점은 무엇인가

  1. 추정 매출이다. 카드 결제를 바탕으로 한 추정값이라 계좌이체가 많은 학원은 실제보다 작게 잡혔을 수 있다. 매출은 분기별 합계로 제공되며, 학원 밀도는 이 분기 매출을 기준으로 한 값이다. 동 사이 비중(LQ, 다양성)은 비율이라 매출의 기간 단위와 무관하다.
  2. 점포 소재지 기준이다. 매출은 학원이 있는 동에 잡히고 학생이 사는 동과는 관계가 없다. 학원 밀도의 분모(생활인구)는 하루 8개 시간대의 평균이라 학교나 집에 있는 학생도 포함하며, 학원에 다니는 학생만 센 것이 아니다.
  3. "학원" 업종 정의의 한계가 있다. 일반교습학원이 청소년 입시·보습 학원을 대표하지만, 영어 어학원은 외국어학원으로 분류되어 빠졌을 수 있고 성인 대상 학원이 섞여 있을 수 있다(노량진2동이 그 예일 수 있다). 업종 분류의 세부 정의는 확인하지 못했다.
  4. "학원 특화 동"의 정의가 결과에 영향을 준다. 기준(LQ 1.5, +10%p)은 분석자가 정했고, 정의에 따라 일부 비교 결과가 달라질 수 있다(예: 다양성 비교).
  5. 행정동 경계의 영향(MAUP)이 있다. 대치동은 대치1·2·4동으로 나뉘어 있어서 하나로 묶으면 값이 달라질 수 있다.
  6. 용도지역은 법적 구분이다. 주거지역 안에도 상가가 있고 학원은 상가 건물에 입지하므로, 용도지역과의 상관은 주거지에 둘러싸인 상가를 뜻할 수 있다. 이 해석은 자료로 검증하지 않았다. 세 구분의 비율이 서로 반대로 움직이는 점도 고려해야 한다. 준주거지역을 상업지역과 묶은 것은 분석자의 분류이며, 다르게 분류했을 때의 결과 차이는 확인하지 않았다.
  7. 한 분기(2026년 2분기)의 단면이다. 학원가가 어떻게 생기고 변해 왔는지, 아파트가 학원을 부르는지 학원이 아파트 가치를 높이는지는 알 수 없다. 상관관계일 뿐 인과관계가 아니다.
  8. 생활밀착 63개 업종만 다뤘다. 백화점, 사무실, 온라인 소비는 없고, 다양성은 업종 구성으로만 쟀다. 거리의 분위기나 소음 같은 체감은 반영하지 못했다.

자료 출처: 서울 열린데이터광장(상권분석서비스 추정매출, 생활인구), 도시계획정보서비스(용도지역), 행정동 경계. 계산 코드와 출력은 각 그림 아래에서 펼쳐 볼 수 있다.